> For the complete documentation index, see [llms.txt](https://red-neuronal-artificial.gitbook.io/neuronas/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://red-neuronal-artificial.gitbook.io/neuronas/contenido/1.-introduccion-a-las-redes-neuronales./1.1-arquitectura-de-una-neurona-artificial.md).
# 1.1 Arquitectura de una neurona artificial
### Perceptrón
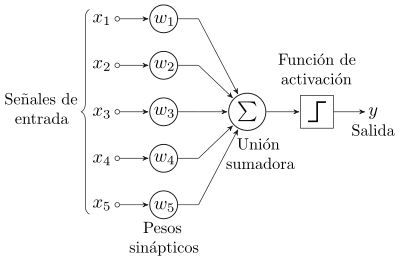
La arquitectura de una neurona artificial, también conocida como perceptrón, consta de los siguientes componentes:
Perceptrón.
1. Entradas: La neurona artificial recibe una serie de entradas numéricas, cada una de las cuales representa una característica o atributo del dato de entrada. Estas entradas se multiplican por los pesos correspondientes.
2. Pesos: Cada entrada está asociada a un peso que indica la importancia relativa de esa entrada en el cálculo realizado por la neurona. Los pesos determinan cómo se combinan las entradas para producir una salida.
3. Sumador ponderado: Las entradas multiplicadas por sus pesos correspondientes se suman para formar una suma ponderada. Esta suma representa la combinación lineal de las entradas y los pesos.
4. Función de activación: La suma ponderada pasa a través de una función de activación, que introduce no linealidad en la neurona. La función de activación puede ser una función sigmoide, una función ReLU (Rectified Linear Unit) u otra función no lineal.
5. Salida: La salida de la neurona artificial es el resultado de aplicar la función de activación a la suma ponderada. Puede ser un valor binario, una probabilidad, una clasificación o cualquier otro tipo de salida deseada según el problema que se esté abordando.
6. Umbral (opcional): En algunas variantes de las neuronas artificiales, se utiliza un umbral adicional que determina si la salida de la neurona supera un cierto valor. Si la salida es mayor que el umbral, se activa; de lo contrario, permanece inactiva.
### Perceptrón multicapa
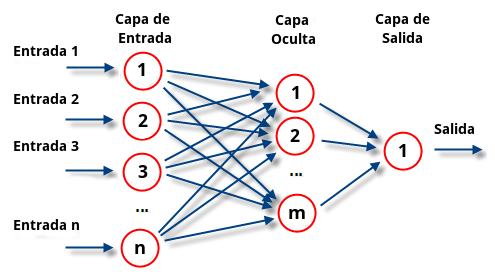
El Perceptrón Multicapa (Multilayer Perceptron, MLP) es una arquitectura de red neuronal artificial que consta de múltiples capas de neuronas interconectadas. Es una de las arquitecturas más comunes y utilizadas en el campo del aprendizaje profundo (deep learning) y se caracteriza por las siguientes características:
1. Capas ocultas: El MLP consta de una o más capas ocultas entre la capa de entrada y la capa de salida. Cada capa oculta está compuesta por un conjunto de neuronas que procesan la información y transmiten las señales a través de conexiones ponderadas hacia las capas siguientes.
2. Neuronas con funciones de activación no lineales: Cada neurona en el MLP utiliza una función de activación no lineal para introducir no linealidad en el modelo. Las funciones de activación comunes incluyen la función sigmoide, la función ReLU (Rectified Linear Unit) y la función tanh (tangente hiperbólica).
3. Conexiones ponderadas: Las conexiones entre las neuronas tienen pesos asociados que determinan la importancia relativa de la señal transmitida. Estos pesos se ajustan durante el proceso de entrenamiento para optimizar el rendimiento de la red.
4. Propagación hacia adelante (Forward Propagation): La información fluye a través de la red desde la capa de entrada hasta la capa de salida mediante la propagación hacia adelante. Cada neurona en una capa realiza una combinación lineal de las salidas de las neuronas en la capa anterior, seguida de la aplicación de la función de activación.
5. Aprendizaje mediante retropropagación (Backpropagation): El MLP se entrena utilizando el algoritmo de retropropagación, que ajusta los pesos de las conexiones de manera iterativa para minimizar una función de pérdida. El algoritmo calcula el gradiente de la función de pérdida con respecto a los pesos y lo propaga hacia atrás a través de la red para actualizar los pesos.
6. Aplicaciones: El MLP se utiliza en una amplia variedad de aplicaciones, como clasificación de imágenes, reconocimiento de voz, procesamiento de texto, pronóstico financiero y muchas otras tareas de aprendizaje automático. Su capacidad para aprender representaciones no lineales y modelar relaciones complejas entre variables lo hace adecuado para problemas complejos.
{% embed url="" fullWidth="true" %}